Accélération matérielle, HPC et finance quantitative
Je travaille à rendre les réseaux de neurones moins coûteux à exécuter sur du vrai matériel, des CNN sur FPGA aux LLM sur plusieurs GPU, et je construis des pipelines de données de marché et une recherche de portefeuille par ML pour les actions brésiliennes et américaines.
Ouvert àIngénierie ML et recherche en IA · Recherche quantitative · HPC
Travaux en cours
Recherche · UFRGS · depuis 2026
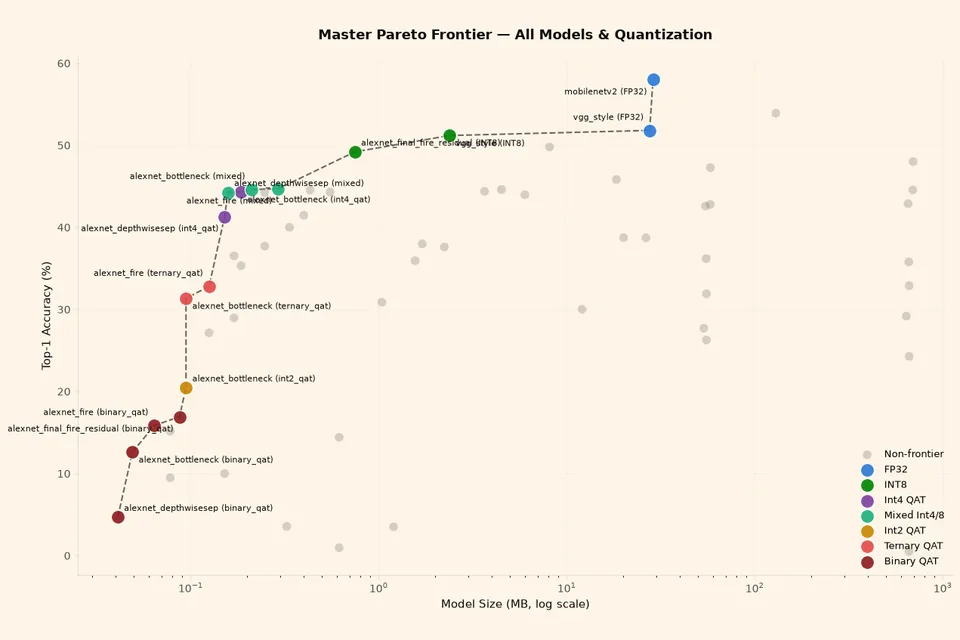
Noyaux 3×3 et 2×2 en alternance : 24 % de MAC en moins, sans perte de précision mesurable
Étude de taille de noyau en 152 exécutions sur Tiny ImageNet, plus détection et segmentation sur PASCAL VOC · FP32 → QAT → INT8 · exécutée sur PCAD (Slurm)
Réseaux de neurones adaptés au matériel : comment limiter les noyaux d’un CNN aux tailles 2×2 et 3×3, que le matériel Winograd traite bien, affecte la précision, l’efficacité et la quantification INT8. Sous la direction du professeur Mateus Grellert, du Groupe de microélectronique de l’UFRGS.
Contribution et apprentissages
Comment je contribueJe mène l’étude de taille de noyau de bout en bout sur PCAD, le cluster HPC de l’UFRGS, via Slurm : 152 exécutions dans l’étude principale, plus des séries de robustesse et des séries hybrides sur Tiny ImageNet et PASCAL VOC, chacune entraînée en FP32, puis avec un entraînement tenant compte de la quantification, puis convertie en INT8.
Ce que j’apprendsMesurer le bruit de la graine avant de se fier à une différence : entre deux exécutions uniques, la graine seule déplace l’écart de 0,7 à 1 point, donc tout ce qui reste dans cette bande est une égalité, et la meilleure des 24 configurations a dû être relancée avec deux graines de plus avant que je m’y fie. Au-delà de la technique : garder une étude de 152 exécutions organisée et reproductible, et présenter les résultats à mon directeur avec leurs limites, pas seulement les bonnes nouvelles.
Python
Deep learning
Quantification
HPC
Collaboration de recherche · UFRGS · depuis 2026
Winograd 4 bits sur FPGA : quatre produits par DSP, 1,98× le débit en 8 bits
3 379 GOPS sur VGG16 avec 1 024 DSP (ZCU104) · le réseau 4 bits que j’ai entraîné : 68,51 % de top-1 sur ImageNet, 3,08 points sous la version en virgule flottante
Accélérateurs Verilog pour la convolution 3×3 avec l’algorithme de Winograd (F(2,3), F(4,3), F(6,3) ; INT8 et 4 bits), conçus par mon collègue de laboratoire Thomas Schmitz ; j’apporte le côté réseau et précision. Coauteur d’un article invité dans IEEE OJCAS qui prolonge l’article de Thomas à SBCCI 2026 (en préparation) et d’un article soumis à ISCAS (en cours d’évaluation).
Contribution et apprentissages
Comment je contribueJ’évalue les lignées d’accélérateurs de Thomas sur 16 réseaux adaptés aux noyaux 3×3, sur une AMD Alveo U200 : nombres de cycles issus de la simulation de la netlist, Fmax et puissance issues de Vivado, et précision avec l’arithmétique propre à l’accélérateur. Pour l’article OJCAS, j’ai entraîné le réseau 4 bits directement dans le domaine de Winograd (échelles par filtre, trois graines), je l’ai porté dans le RTL avec le biais et j’ai révisé les chiffres et le texte de l’article.
Ce que j’apprendsUn gain arithmétique est un plafond, pas un débit : des tuiles plus grandes demandent des données plus larges et une fermeture de timing plus difficile, et les chiffres matériels ne comptent que lorsqu’ils correspondent bit à bit à une référence logicielle. Travailler sur la conception de quelqu’un d’autre m’a appris à l’améliorer sans y toucher : mesurer à travers sa batterie de tests, signaler ce qui casse et laisser le concepteur décider.
FPGA
Vivado
Winograd
Quantification
Projet individuel · depuis 2025
Données de marché point-in-time pour la B3 et ~9 600 actions américaines, sans biais d’anticipation ni biais du survivant
B3 depuis 2000, sociétés radiées incluses · États-Unis : 34 M de lignes de prix, fondamentaux SEC EDGAR depuis les années 1990, macro FRED · recherche de portefeuille LightGBM par-dessus, en cours
Recherche en machine learning pour la gestion de portefeuille sur le marché actions brésilien (B3) : un pipeline de données point-in-time et une étude de construction de portefeuille fondée sur LightGBM, évaluée en backtest walk-forward, aujourd’hui étendue aux actions américaines.
Contribution et apprentissages
Comment je contribueJ’ai construit tout le pipeline : prix, fondamentaux de la CVM avec leurs vraies dates de publication, sociétés radiées pour éviter le biais du survivant, et données macro ; puis un modèle d’alpha LightGBM, un modèle de risque et un optimiseur qui tient compte des coûts. Pour l’extension aux États-Unis, j’ai collecté les prix de ~9 600 tickers (34 M de lignes), les fondamentaux SEC EDGAR depuis les années 1990 et les données macro de FRED.
Ce que j’apprendsUne configuration choisie parmi de nombreux backtests ne vaut pas grand-chose tant qu’elle n’est pas corrigée pour les tests multiples (un test de ratio de Sharpe déflaté me l’a montré), et le biais du survivant et les dates de publication comptent autant que le modèle. Mener seul un projet long m’a appris l’autogestion : fixer mes propres jalons, changer une variable par expérience et être mon propre relecteur, si bien qu’aucune couche n’entre tant que celle du dessous ne bat pas sa référence.
Python
LightGBM
Validation walk-forward
Optimisation de portefeuille
Parcours
Je suis étudiant en génie informatique à l’UFRGS, l’une des universités les plus prestigieuses du Brésil, classée en 2022 meilleure université fédérale du pays par le ministère de l’Éducation. Auparavant, j’ai étudié le génie électrique à l’UFSC. Je travaille à l’intersection du matériel et du machine learning : ma recherche actuelle cherche à mieux adapter les réseaux de neurones aux accélérateurs matériels. Je dois une grande partie de ce travail à mon directeur, le professeur Mateus Grellert, dont l’encadrement a façonné ma manière de faire de la recherche.
En dehors du laboratoire, je construis des données de marché point-in-time et une recherche de portefeuille par ML pour les actions de la B3 et des États-Unis.
À l’UFSC, j’ai construit un scanner laser 3D pour un projet de ROV d’inspection sous-marine et travaillé dans l’équipe Shell Eco-marathon. Depuis, j’ai dirigé une équipe de trois au défi IBM SkillsBuild, construit une prévision de la saison des feux au NASA Space Apps et, hors de l’ingénierie, participé à l’UFRGSMUN, en négociant des propositions et en conciliant des points de vue opposés.
UniversitéUFRGS — Génie informatique
AuparavantUFSC — Génie électrique
LanguesPortugais · Anglais · Français · Espagnol
Expérience
LABMETRO · UFSC · 2025 · Vision + embarqué
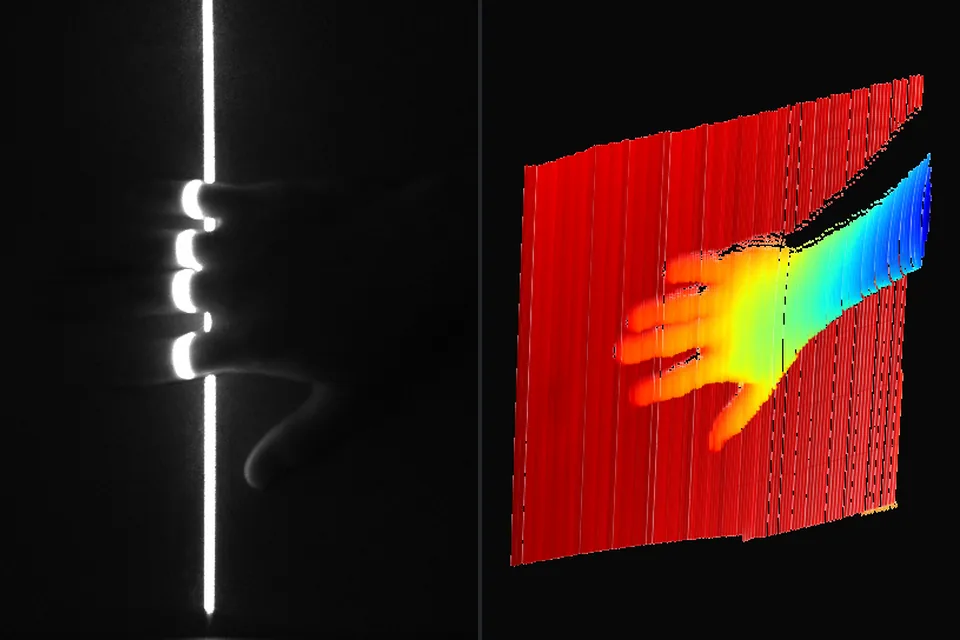
Scanner laser 3D à bas coût pour l’inspection sous-marine, du matériel au nuage de points
Caméra, laser et miroir rotatif piloté par encodeur (Arduino) · extraction sous-pixel de la ligne laser · modèle de profondeur par gradient boosting · ROV financé par la FINEP à l’UFSC
VORIS (Véhicule télé-opéré pour l’inspection sous-marine) est un projet financé par la FINEP au Laboratoire de métrologie et d’automatisation (LABMETRO) de l’UFSC, avec Petrobras comme partie intéressée : un ROV doté de systèmes optiques de mesure 3D pour les structures immergées. Dans le cadre de ma recherche de premier cycle, avec le professeur Diego Fabre, j’ai construit et évalué son banc d’essai de triangulation laser : une caméra, un laser et un miroir rotatif qui balaient une scène et la transforment en nuage de points 3D.
Contribution et apprentissages
Ma contributionJ’ai construit le système de bout en bout : le matériel (un Arduino Uno R4 pilotant un miroir à moteur pas à pas lu par un encodeur absolu, commande PWM du laser et capture d’images synchronisée avec l’angle de balayage), l’extraction sous-pixel de la ligne laser par un centroïde pondéré par l’intensité (bien moins bruité qu’un seuillage), le modèle géométrique de triangulation (normalisation de la caméra, géométrie caméra–laser et correction de l’angle du miroir), un modèle de régression par gradient boosting entraîné sur des scans annotés pour corriger les erreurs systématiques de profondeur, et une interface graphique pour piloter l’ensemble.
Ce que j’ai apprisUn modèle ne vaut que par sa calibration : la géométrie était précise près du centre de l’image, mais de petites erreurs de calibration et d’angle du laser grandissaient vers les bords. Apprendre ces erreurs à partir des données a réduit les artefacts à cet endroit, mais seulement jusqu’où allaient les données d’entraînement, ce qui plaide pour un hybride avec la géométrie comme socle. Travailler au LABMETRO m’a aussi placé, moi, étudiant en génie électrique, dans un laboratoire de génie mécanique aux côtés de métrologues et de chercheurs en vision par ordinateur, avec des professeurs de spécialités différentes : j’ai appris à expliquer mon sous-système dans les termes de chacun, à transformer leurs critiques en améliorations du banc d’essai et à tenir le calendrier d’un projet financé.
Vision par ordinateur
Systèmes embarqués
Reconstruction 3D
Machine learning
Équipe de compétition étudiante · 2025 · Ingénierie + marketing
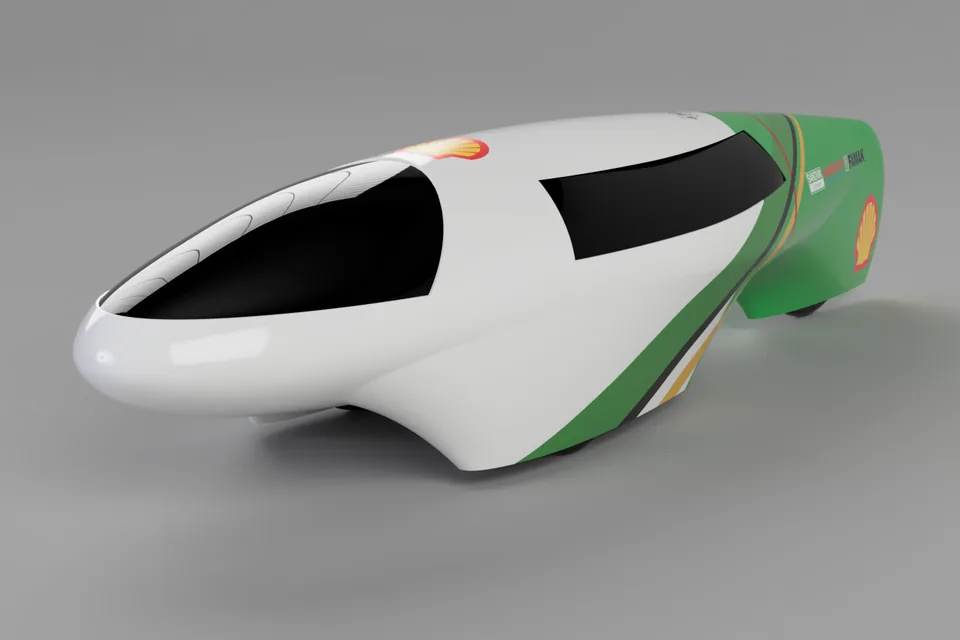
Composites en fibre de carbone sur un prototype ultra-économe, et le marketing de l’équipe
Équipe Shell Eco-marathon · prototypes essence et électrique · visite technique chez Nanopoxy (résines époxy)
L’E3 (Équipe d’efficacité énergétique de l’UFSC) conçoit, construit et valide des prototypes ultra-économes, à essence et électriques, pour la Shell Eco-marathon. Je l’ai rejointe en 2025 et j’ai travaillé sur l’ingénierie de la voiture et le marketing de l’équipe.
Contribution et apprentissages
Ma contributionJ’ai surtout travaillé sur l’ingénierie de la voiture, notamment sur des pièces en composites de fibre de carbone ; j’ai participé à une visite technique chez Nanopoxy, fabricant de résines époxy pour composites — la même famille de matériaux que celle utilisée dans la voiture ; et j’ai fait le marketing de l’équipe tout en organisant le pôle marketing.
Ce que j’ai apprisComment la fibre de carbone et la résine époxy se combinent en pièces légères et rigides et, chez Nanopoxy, ce qui entre dans la fabrication des résines elles-mêmes. Organiser le pôle marketing voulait dire répartir les tâches entre coéquipiers, fixer des échéances et assurer le suivi ; le faire en parallèle du travail d’ingénierie m’a obligé à prioriser, et à expliquer le côté technique de la voiture dans des termes que des personnes extérieures à l’ingénierie pouvaient suivre.
Ingénierie
Composites en fibre de carbone
Marketing
Travail d’équipe
Projets
Hackathon · 2026 · NASA Space Apps
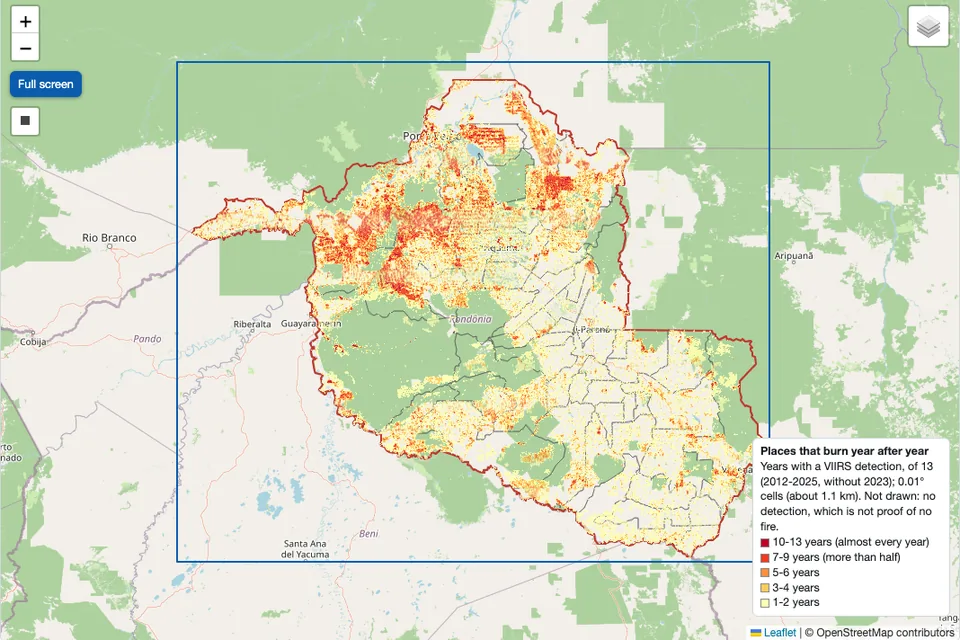
Prévoit où le Brésil brûlera la saison prochaine, cellule par cellule
NASA FIRMS, MODIS + VIIRS fusionnés (2000–2026) · un simple modèle de ratios a battu le challenger ML · attestation de participation
Une application web qui fusionne les détections de feux NASA FIRMS des deux capteurs satellitaires en une série cohérente et la transforme en calendrier mensuel des brûlis, testée d’abord au Rondônia puis étendue à tous les États brésiliens.
Contribution et apprentissages
Ma contributionL’un des deux principaux développeurs (67 commits). J’ai construit les vues saison des feux et « par rapport à la normale », la prévision de la saison suivante avec des probabilités de feu par cellule, le pilote national avec les limites de l’IBGE et des outils de terrain (liens partageables, « où agir d’abord », import de zones personnalisées). J’ai aussi testé un challenger ML, qui n’a pas battu la méthode des ratios, plus simple, et écrit les tests du pipeline.
Ce que j’ai apprisLes données satellitaires doivent être réconciliées entre capteurs avant que toute analyse ait un sens, et une référence simple et explicable peut battre le ML ; le rapporter honnêtement fait partie du résultat. Le hackathon m’a appris à coder sous pression : réduire le périmètre tôt, livrer d’abord le cœur, répartir clairement le travail avec l’autre développeur principal, relire vite le code l’un de l’autre et garder des tests pour que la vitesse ne casse pas ce qui marche déjà.
Python
JavaScript
NASA FIRMS
Géospatial
Prototype en ligne · j’ai dirigé une équipe de 3
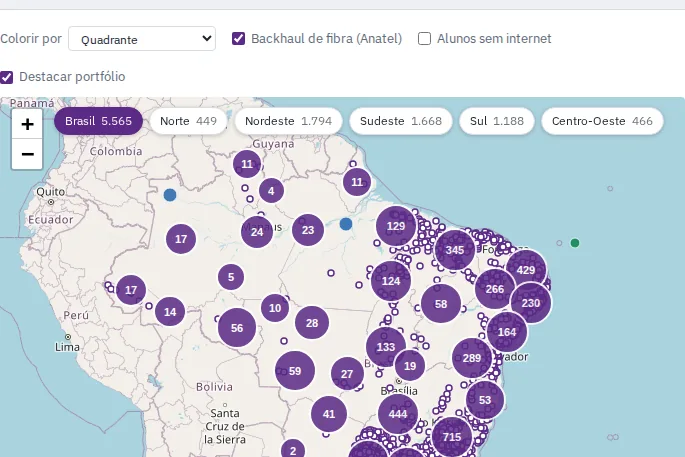
Plan de connectivité optimal sous contrainte budgétaire pour les 5 570 communes du Brésil
VAN, délai de récupération et optimisation de portefeuille · explications d’IBM Granite vérifiées par rapport aux chiffres · 230 tests automatisés
Système d’aide à la décision pour le défi IBM SkillsBuild & Fundação Telefônica Vivo : classe les communes pour l’extension de la connectivité à partir de données publiques (Anatel, IBGE, INEP), d’une analyse financière, d’une optimisation de portefeuille et d’un agent IBM Granite qui explique chaque recommandation.
Contribution et apprentissages
Ma contributionJ’ai dirigé l’équipe de trois qui l’a construit et j’étais responsable du moteur de décision : les scores de priorité des communes, les distances de backhaul, l’outil financier (délai de récupération, VAN, sensibilité), l’optimisation de portefeuille avec PuLP/CBC (IBM CPLEX en option) et un backtest 2021→2025. J’ai aussi mené l’intégration : le backend FastAPI, les vérifications que le texte de Granite correspond aux chiffres du moteur, la CI et le déploiement.
Ce que j’ai apprisComment transformer une question métier en modèle d’optimisation avec de vraies contraintes budgétaires, et pourquoi la sortie d’un LLM doit être vérifiée par rapport aux données. En dirigeant le projet, j’ai appris à répartir le travail selon qui maîtrisait le mieux chaque partie, à figer tôt les interfaces et des données fictives pour que données, moteur et interface avancent en parallèle, et à trancher quand les pièces devaient s’assembler avant l’échéance.
Python
FastAPI
Optimisation
IBM watsonx
Benchmark terminé · équipe de 3
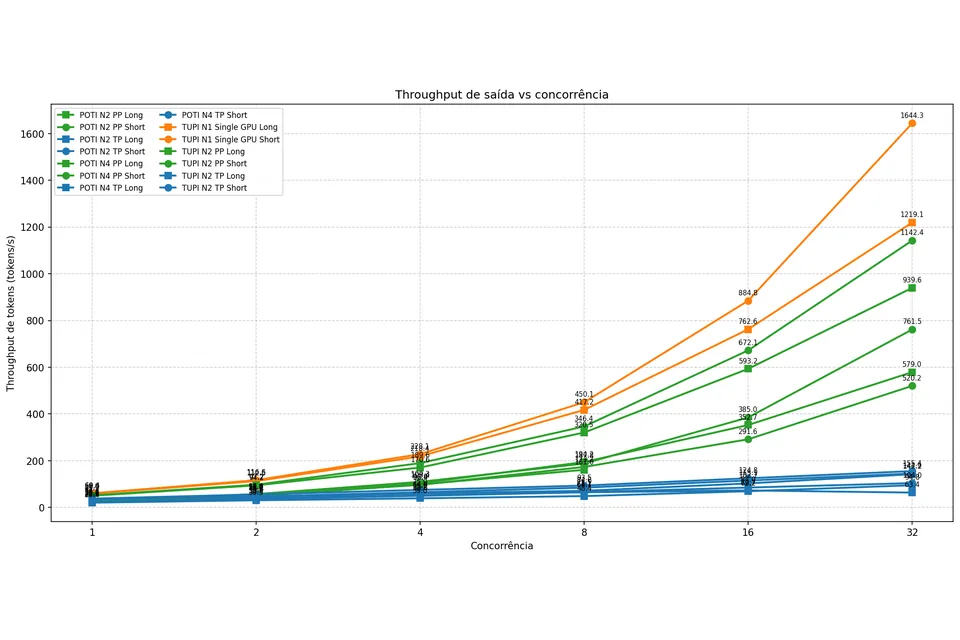
Entre nœuds, le parallélisme de tenseurs a passé jusqu’à 97 % du temps GPU en communication
Qwen2.5-7B sur 1 à 4 GPU · vLLM + Ray sur PCAD, le cluster HPC de l’UFRGS · à retenir : si le modèle tient sur un GPU, inutile de le découper
Projet du cours d’évaluation des performances de l’UFRGS : compare le parallélisme de tenseurs et le parallélisme de pipeline pour l’inférence de LLM (vLLM et Ray) sur PCAD, le cluster HPC de l’UFRGS.
Contribution et apprentissages
Ma contributionJe me suis chargé du volet GPU et réseau de l’analyse : télémétrie GPU (utilisation, consommation électrique), mesures réseau, notebooks et graphiques d’analyse statistique, scripts d’exécution et présentation finale.
Ce que j’ai apprisComment concevoir une expérience de performance avec facteurs et répétitions, et comment le parallélisme de tenseurs et celui de pipeline déplacent le goulot d’étranglement entre calcul et communication. Être responsable d’une partie d’une étude en équipe m’a appris à convenir du plan dès le départ, à livrer des données que les autres pouvaient utiliser directement et à planifier les exécutions en fonction de la file d’attente d’un cluster HPC partagé.
Python
vLLM
HPC
Prototype terminé · en solo
Range un dossier en désordre par sens, pas par nom de fichier
Embeddings de phrases + KMeans · YAKE nomme chaque dossier · aperçu avant tout déplacement
Organisateur de documents par IA qui utilise des embeddings de phrases, l’extraction de mots-clés et un clustering KMeans pour regrouper les fichiers par similarité sémantique.
Contribution et apprentissages
Ma contributionJe l’ai construit seul : extraction de texte depuis PDF, DOCX, TXT et XML, plus transcription audio hors ligne avec Vosk, embeddings de phrases avec KMeans, mots-clés YAKE pour nommer chaque dossier et un aperçu avant tout déplacement de fichier.
Ce que j’ai apprisAppliquer le NLP à des fichiers réels et désordonnés, et comprendre que des clusters non supervisés ne servent qu’avec des étiquettes lisibles. Le construire seul m’a appris à réduire d’abord le périmètre à un prototype qui marche et à concevoir pour la confiance de l’utilisateur : un outil qui déplace des fichiers doit toujours montrer un aperçu.
Python
NLP
Clustering
Contribution open source
Assistant de cours par IA et prévision de fin d’études pour les étudiants de l’UFRGS
Pull request non fusionnée (le dépôt d’origine n’est plus maintenu) · Vue · endpoint IA avec limitation de débit · tests Vitest
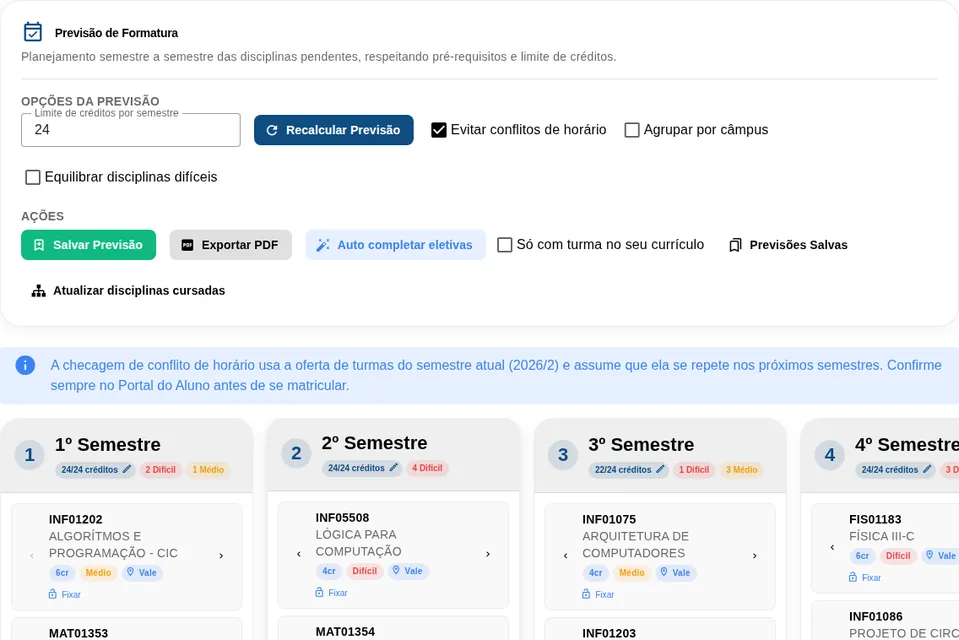
Pull request vers une application open source d’aide à l’inscription aux cours de l’UFRGS, qui ajoute des fonctions qui me manquaient quand je l’utilisais comme étudiant.
Contribution et apprentissages
Ma contributionJ’ai ajouté un assistant IA pour les questions sur les cours et les emplois du temps (limité au cursus sélectionné, avec CORS/CSP de production et limitation de débit), une prévision de fin d’études avec export PDF, l’export de l’emploi du temps en .ics avec comparaison côte à côte, et mis en place Vitest avec des tests pour les services principaux.
Ce que j’ai apprisComment contribuer au code de quelqu’un d’autre : suivre ses conventions, garder une pull request ciblée et expliquer pourquoi chaque changement compte pour que le mainteneur puisse la relire vite ; et comment ajouter des tests autour d’un code que je n’ai pas écrit.
Vue
Vitest
Open source
Projet de cours · Algorithmes et programmation (INF01202) · en binôme
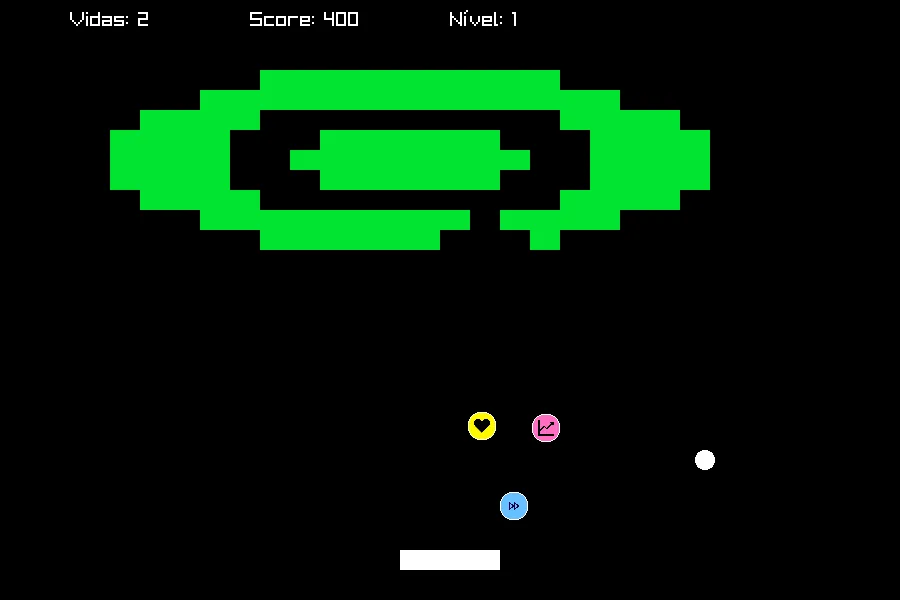
Un jeu d’arcade complet en C, mémoire et E/S de fichiers gérées à la main
32 des 38 commits sont de moi · Raylib · sauvegardes binaires avec classement des scores
Un casse-briques de style arcade écrit en C avec Raylib : déplacement au clavier, détection des collisions, vies, score, bonus et plusieurs niveaux chargés depuis des fichiers.
Contribution et apprentissages
Ma contributionJ’ai écrit l’essentiel du code (32 des 38 commits) : états de jeu modulaires, collisions, bonus, niveaux chargés depuis des fichiers, fichiers de sauvegarde binaires avec classement des scores, audio et HUD.
Ce que j’ai apprisStructurer un programme C en modules et gérer la mémoire et les E/S de fichiers à la main. Travailler en binôme m’a appris à découper le jeu en modules dont chacun de nous pouvait être responsable, à convenir des interfaces entre eux et à utiliser Git pour garder notre travail synchronisé.
C
Raylib
Systèmes de jeu
Activités
Simulation de l’ONU · 2026 · en anglais
Négociation de politiques antiterroristes et de cybersécurité ; choisi par la presse pour une interview spéciale
Bureau de lutte contre le terrorisme de l’ONU · terrorisme au Sahel et cyberterrorisme · l’un des quatre délégués interviewés devant toute la conférence
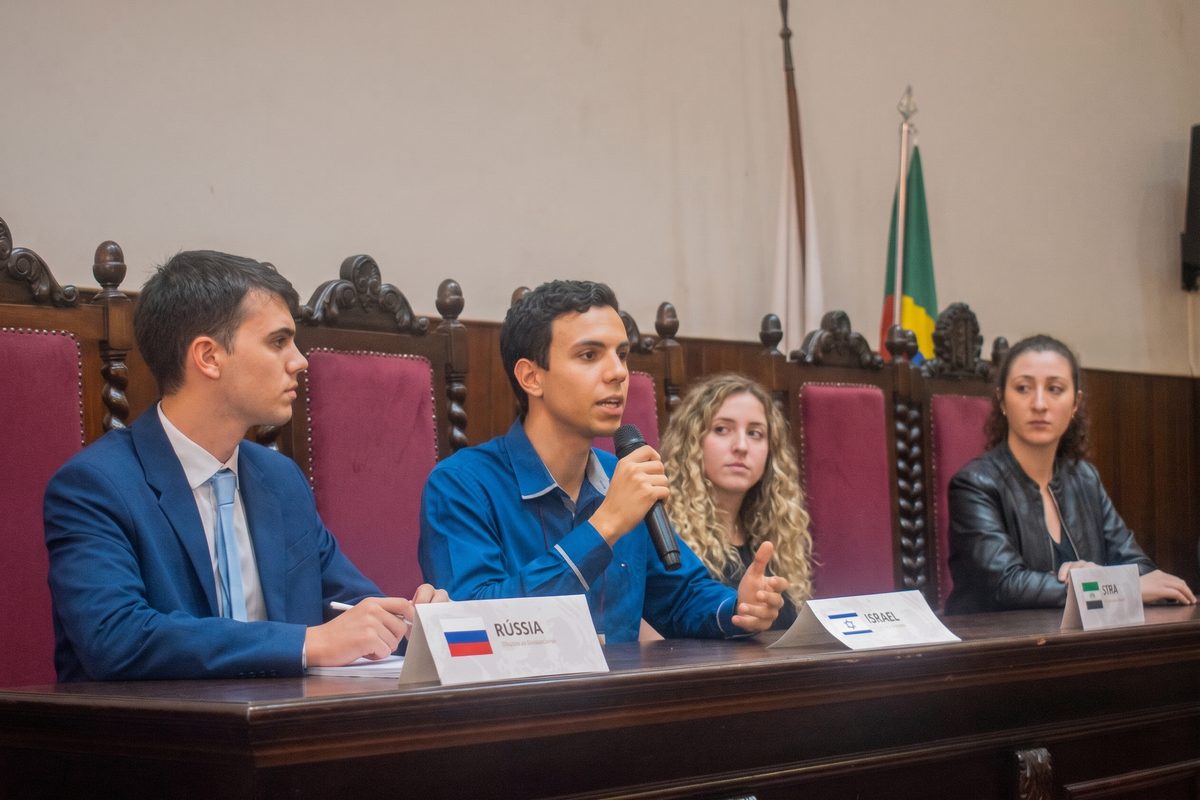
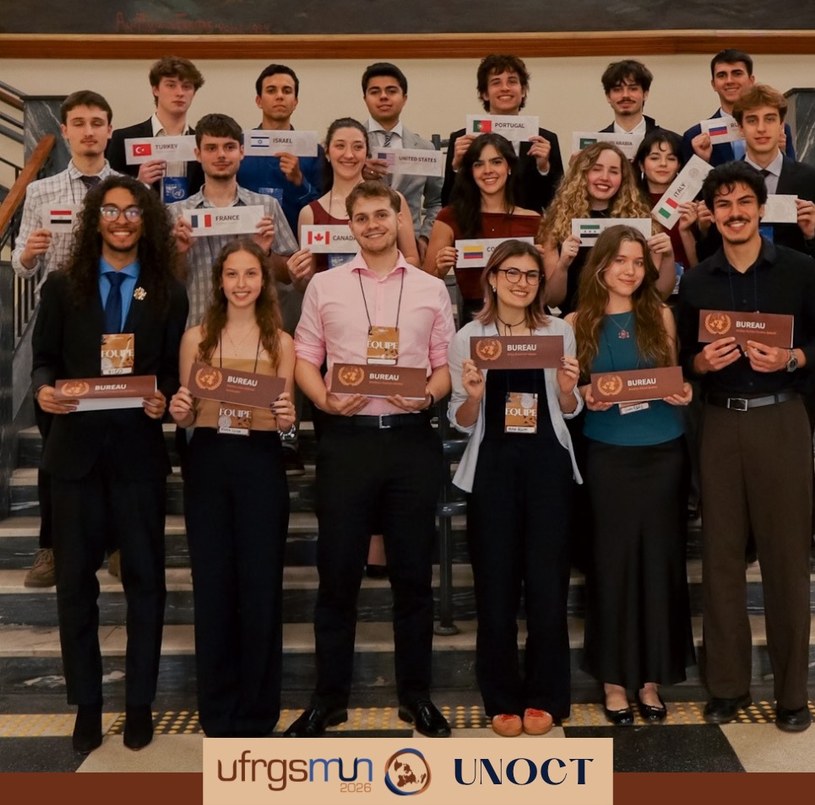
La simulation des Nations Unies de l’UFRGS. En tant que délégué d’Israël au Bureau de lutte contre le terrorisme des Nations Unies (UNOCT), j’ai débattu en anglais du terrorisme au Sahel et du cyberterrorisme, en négociant avec des délégations dont les positions étaient souvent éloignées de la mienne.
Contribution et apprentissages
Ma contributionPour me préparer, j’ai suivi de près l’actualité du cyberterrorisme, de la cybersécurité et du Sahel. En comité, j’ai représenté Israël et négocié en caucus avec d’autres délégations la formulation des mesures antiterroristes, en cédant là où cela coûtait peu et en tenant bon sur les points auxquels Israël ne pouvait pas renoncer. L’équipe de presse m’a choisi comme l’un des quatre délégués pour une interview spéciale devant tous les participants, où j’ai défendu la position de ma délégation et répondu à une question critique des journalistes.
Ce que j’ai apprisLes accords sont venus de la compréhension des raisons de chaque délégation, pas de la répétition de ma position. J’ai appris à travailler avec des délégations dont les vues étaient éloignées de celles d’Israël, à négocier des formulations acceptables pour plusieurs parties, à construire un bloc autour d’un texte commun et à défendre une position difficile en public, en anglais, sans perdre en précision. La préparation est aussi devenue une habitude : je suis la cybersécurité et la géopolitique au quotidien, des nouvelles attaques et vulnérabilités aux conflits régionaux et aux débats de sécurité qui les entourent, car un argument ne tient que s’il reflète la situation actuelle.
Diplomatie
Négociation
Prise de parole en public
Cybersécurité
Stack et contact
Compétences
Systèmes et accélération
C
C++
CUDA
FPGA (Vivado)
vLLM
Ray
Slurm (cluster PCAD)
ML et données
Python
PyTorch
Quantification (QAT/INT8)
Deep learning
Apprentissage par renforcement
LightGBM
Vision par ordinateur
NLP
Génie logiciel
FastAPI
Vue
React
TypeScript
JavaScript
Node.js
Express
Tailwind CSS
Firebase
Docker
Git
Langues
Portugais (langue maternelle)
Anglais (courant)
Français (avancé)
Espagnol (avancé)
Contact
Parlons-en.
Ouvert àIngénierie ML et recherche en IA · Recherche quantitative · HPC
 Recherche · UFRGS · depuis 2026